بحران حافظهٔ PostgreSQL؛ شاید RAM مقصر نیست!
در این مقاله معماری Memory در PostgreSQL رو از مدل Process و هزینهٔ هر Connection تا ساختار Shared Memory و تنظیمات کلیدی اون بررسی میکنیم. اما قبلش باید به یک سوال جواب بدیم:
چرا معماری PostgreSQL مهمه؟!
تا حالا از خودت پرسیدی چرا PostgreSQL نمیتونه مثل بعضی Databaseهای دیگه، ۱۰٬۰۰۰ تا Connection رو مدیریت کنه؟ یا چرا سرور PostgreSQL با اینکه RAM زیادی داره، یهو با کمبود Memory روبهرو میشه؟
جواب توی معماری Memory در PostgreSQL پنهانه؛ طراحیای که طی چند دهه بهتر شده، ولی خیلی وقتها درست درکش نمیکنیم. توی این مجموعهٔ دوبخشی، مدیریت Memory در PostgreSQL رو باز میکنیم تا بتونی Database رو بهتر تنظیم کنی، توی دام اشتباههای رایج نیفتی و مشکلات Performance رو پیدا کنی.
در بخش اول، این موضوعها رو بررسی میکنیم:
• چرا PostgreSQL از Process بهجای Thread استفاده میکنه و این انتخاب چه اثری روی محیط Production داره؟
• اجزای Shared Memory چطوری کمک میکنن Database سریع کار کنه؟
• چطور اندازهٔ پارامترهای مهمی مثل shared_buffers رو تعیین کنیم؟!
• Huge Pages چطور میتونه Performance رو بهتر کنه؟
در بخش دوم که بعداً منتشر میشه، سراغ Local Memory، رفتار MVCC و روشهای عملی Monitoring میریم.
۱. انتخاب پایهای PostgreSQL بین Process و Thread
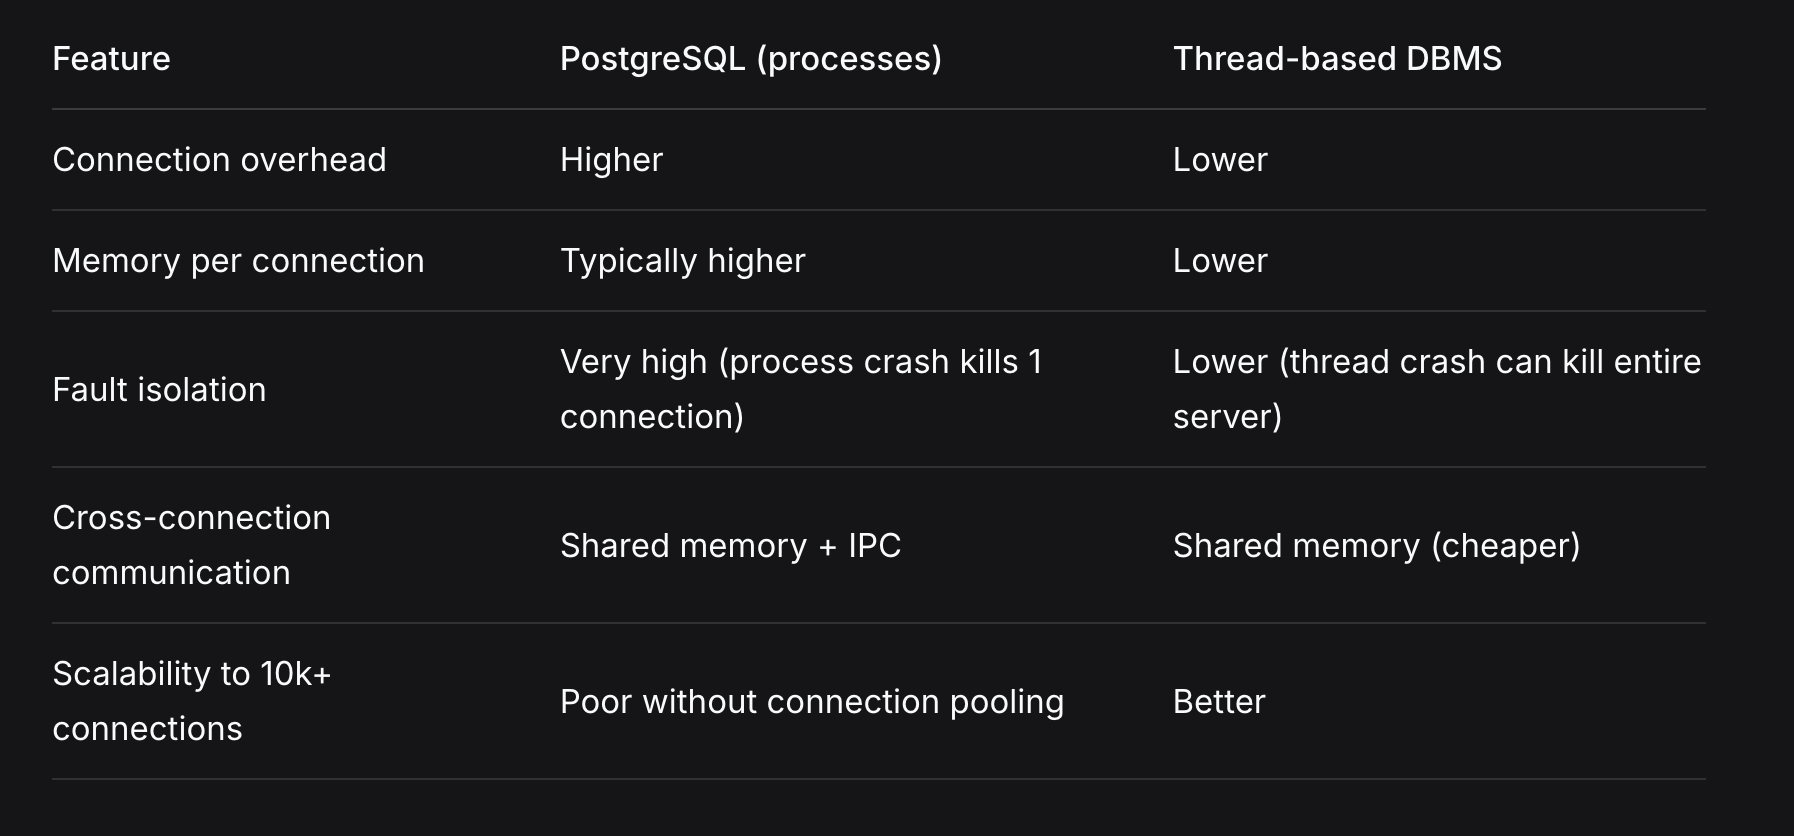
بیایم از پایهایترین تصمیم معماری PostgreSQL شروع کنیم: برخلاف خیلی از Databaseها که از Thread استفاده میکنن، PostgreSQL برای هر Connection از طرف Client، یه Process جدید Fork میکنه.
جدول مقایسه
چرا Process رو انتخاب کردن؟!
تیم PostgreSQL همینطوری این تصمیم رو نگرفت. توی مقالههای اولیهٔ پروژهٔ POSTGRES در سالهای ۱۹۸۵ تا ۱۹۸۶، Michael Stonebraker روشن گفته بود که تیم، «Server Model» یا همون Threading و مزیتهای Performance اون رو میشناخته؛ بهاشتراکگذاشتن منابعی مثل File Descriptorها و Bufferها میتونست کارآمدتر باشه.
ولی برای پیادهسازی یه سرور Thread-based قابلاعتماد، باید چیزی شبیه «یه Operating System تقریباً کامل و ویژهمنظوره» میساختن؛ چون پشتیبانی از Threading توی سیستمهای Unix اون زمان هنوز جا نیفتاده بود و Portability خوبی نداشت. منابع برنامهنویسی هم محدود بود؛ پس مدل Process رو انتخاب کردن تا «هرچه زودتر یه سیستم قابلاستفاده راه بندازن».
نکتهٔ جالب اینجاست که Stonebraker مدل Process رو موقتی میدید و برنامه داشت بعداً POSTGRES رو به Lightweight Process یا Thread تبدیل کنه. ولی Performance همین مدل کافی از آب دراومد و معماری اونقدر توی سیستم جا افتاد که تبدیل کاملش به Thread دیگه به یه بازطراحی غیرعملی تبدیل شد.
نتیجهٔ عملی Connection Pooling ضروریه
چون هر Connection یه Process ایجاد میکنه، مدیریت کارآمد هزاران Connection مستقیم از Clientها برای PostgreSQL آسون نیست. راهحل چیه؟ Connection Pooling.
ابزارهایی مثل pgBouncer برای سیستمهای Production با Concurrency بالا ضروریان. pgBouncer یه Pool از Connectionهای واقعی PostgreSQL نگه میداره و درخواستهای Connection برنامه رو بین اونها پخش میکنه. این کار Overhead رو خیلی کم میکنه.
یه نگاه به پشت صحنه
میخوای ببینی PostgreSQL این Processها رو چطور میسازه؟ این قطعهکد از مسیر src/backend/postmaster/postmaster.c رو ببین:
static int
BackendStartup(ClientSocket *client_sock)
{
    PMChild *bn = NULL;
    pid_t pid;

    // ... setup code ...

    pid = postmaster_child_launch(bn->bkend_type, bn->child_slot,
                                  &startup_data, sizeof(startup_data),
                                  client_sock);

    if (pid < 0) {
        // Fork failed - handle the error
        int save_errno = errno;
        (void) ReleasePostmasterChildSlot(bn);
        errno = save_errno;
        ereport(LOG,
                (errmsg("could not fork new process for connection: %m")));
        return STATUS_ERROR;
    }

    // Success - fork completed
    bn->pid = pid;
    return STATUS_OK;
}
هر بار که یه Client وصل میشه، PostgreSQL یه Backend Process جدید Fork میکنه. برای همینه که Connection Pooling اینقدر مهمه!
۲. نمای کلی معماری Memory در PostgreSQL
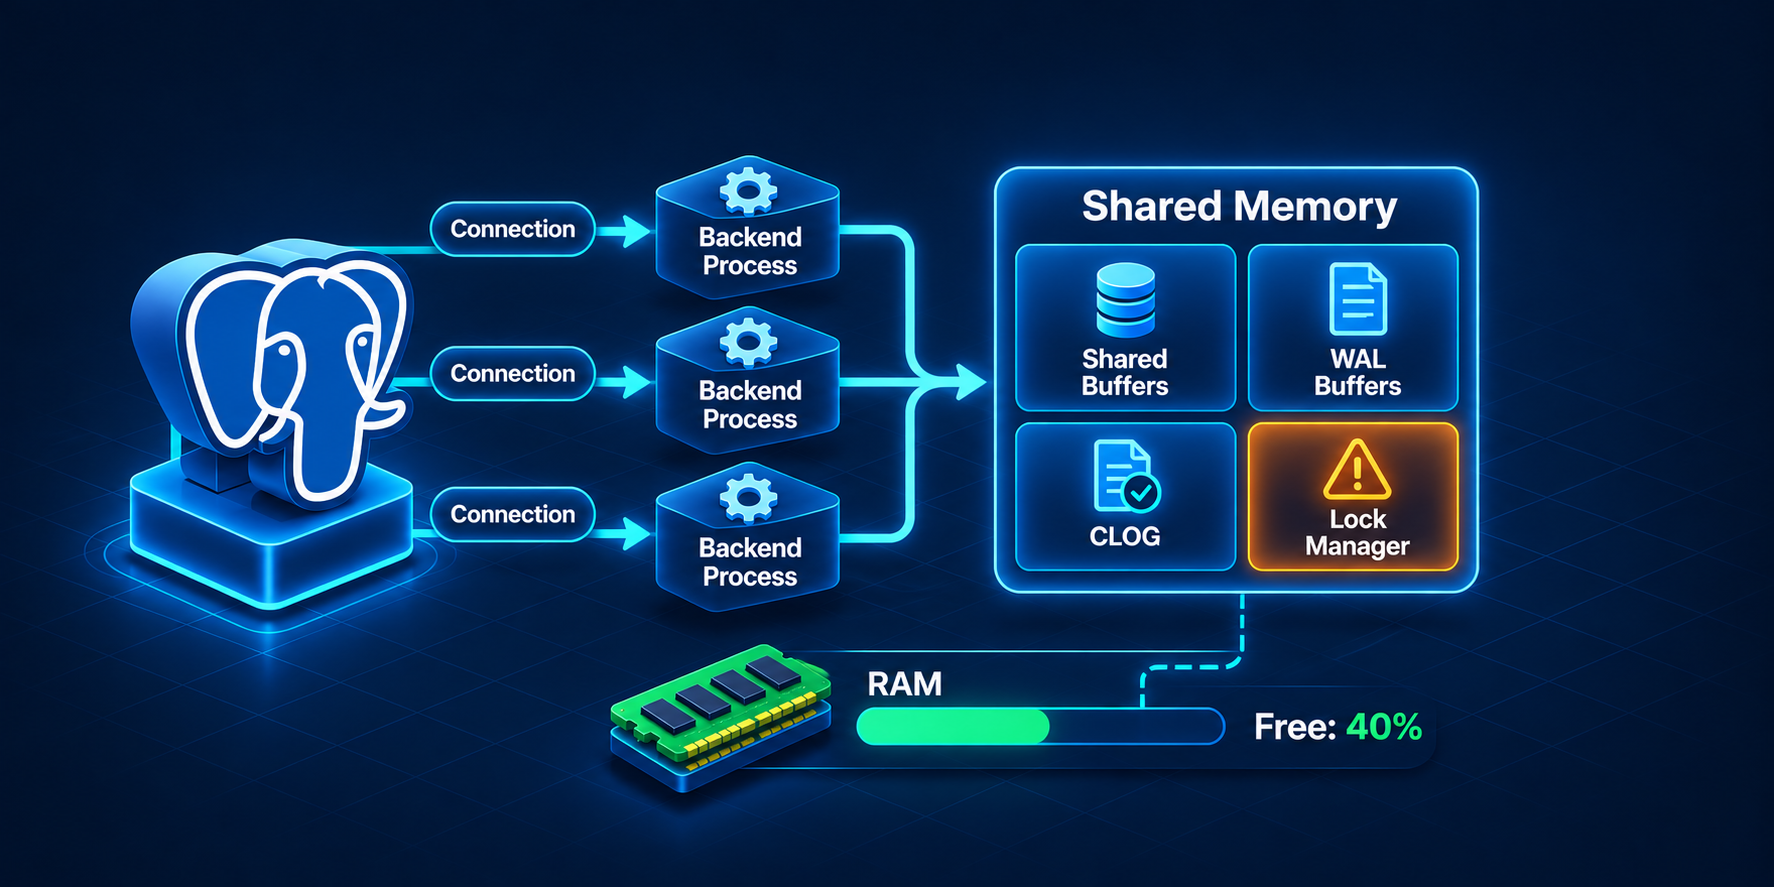
حالا که مدل Process رو شناختیم، بیایم ببینیم Memory چطور سازماندهی میشه. Memory در PostgreSQL دو دسته داره:
Shared Memory در سطح کل سیستم
• Shared Buffers برای Cache کردن Data Pageها.
• WAL Buffers برای Cache کردن Transaction Log.
• CLOG Buffer برای Cache کردن وضعیت Transactionها.
• Lock Tables برای کنترل Concurrency.
Local Memory بهازای هر Backend
• work_mem برای عملیات Sorting و Hash.
• maintenance_work_mem برای VACUUM و ایجاد Index.
• temp_buffers برای Temporary Tableها.
• autovacuum_work_mem برای عملیات Autovacuum.
حالا بریم اجزای Shared Memory رو دقیقتر بررسی کنیم.
۳. بررسی اجزای Shared Memory
۳-۱. Shared Buffers هستهٔ Caching
Shared Buffers Cache همون جاییه که PostgreSQL، Data Pageها و Indexهای پرکاربرد رو توی Memory نگه میداره تا Disk I/O خیلی کمتر بشه.
چه چیزهایی داخلش ذخیره میشه؟!
Data Pageهای Tableها
Pageهای Indexها
Materialization نتایج Query بهصورت Just-in-time
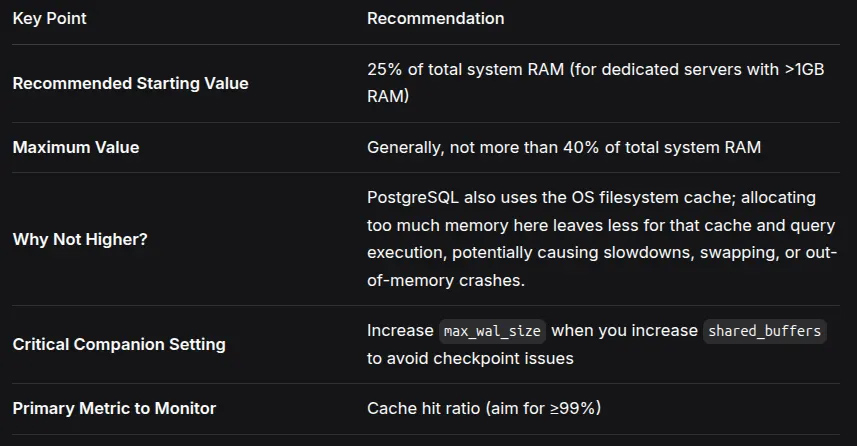
راهنمای تعیین اندازه
بررسی Cache Hit Ratio
برای دیدن Cache Hit Ratio، این Query رو اجرا کن:
SELECT
    sum(heap_blks_read) as heap_read,
    sum(heap_blks_hit)  as heap_hit,
    sum(heap_blks_hit) / (sum(heap_blks_hit) + sum(heap_blks_read)) as hit_ratio
FROM
    pg_statio_user_tables;
اگه Hit Ratio از ۹۹٪ پایینتر اومد، افزایش shared_buffers رو بررسی کن؛ ولی از ۴۰٪ RAM بالاتر نرو!
مشاهدهٔ تنظیم فعلی
SHOW shared_buffers;یه نکتهٔ کاربردی: میتونی shared_buffers رو توی postgresql.conf یا با ALTER SYSTEM تغییر بدی:
ALTER SYSTEM SET shared_buffers = '8GB';
-- Requires server restart
Huge Pages برای افزایش Performance
Huge Pages از اون قابلیتهای اثرگذاره که خیلیها از کنارش رد میشن.
مشکل از این قراره:
• اندازهٔ پیشفرض Page در Linux برابر 4KB است.
• وقتی shared_buffers برابر 8GB باشه، OS باید ۲٬۰۹۷٬۱۵۲ تا Page رو مدیریت کنه.
• مدیریت هر Page برای CPU، Overhead داره.
راهحل، استفاده از Huge Pages است:
• اندازهٔ Page به 2MB میرسه.
• برای shared_buffers برابر 8GB، فقط ۴٬۰۹۶ تا Page لازم میشه.
• تعداد TLB Missها در Translation Lookaside Buffer خیلی کمتر میشه.
اثر واقعی چی بوده؟ توی یه Benchmark، فعالکردن Huge Pages باعث شده Throughput از ۷۵۸٬۹۱۴ به ۱٬۱۸۴٬۰۸۵ Transaction در ثانیه یا TPS برسه؛ یعنی ۵۶٪ بهبود Performance!
چطور Huge Pages رو فعال کنیم؟!
۱. اول تنظیمات سطح OS رو انجام بده:
# Check current huge page settings
cat /proc/meminfo | grep Huge

# Set required number (calculate from shared_buffers)
# PostgreSQL 15+ helps with this parameter:
SHOW shared_memory_size_in_huge_pages;

# On RHEL/CentOS:
echo "vm.nr_hugepages = 4096" >> /etc/sysctl.conf
sysctl -p
۲. بعد PostgreSQL رو تنظیم کن:
-- Set to 'on' or 'try'
ALTER SYSTEM SET huge_pages = 'try';
⚠️ یه هشدار مهم: Transparent Huge Pages یا THP رو فوراً غیرفعال کن. رفتار Dynamic اون باعث افت Performance و ناپایداری PostgreSQL میشه:
echo never > /sys/kernel/mm/transparent_hugepage/enabled۳-۲. WAL Buffer و نقش آن در Durability و Write Performance
WAL Buffer یا Write-Ahead Log Buffer، یه بخش کوچیک از Shared Memory است که WAL Recordها رو موقت نگه میداره؛ همون Metadata که تغییرات Tableها و Indexها رو توضیح میده.
چرا مهمه؟
PostgreSQL اول تغییرات رو توی WAL مینویسه و بعد سراغ Data Fileها میره تا Durability رو تضمین کنه. این همون D در ACID است؛ یعنی Transactionها بعد از Crash هم باقی میمونن.
اندازهاش چقدر باشه؟
SHOW wal_buffers; -- Default: -1 (auto-tuned)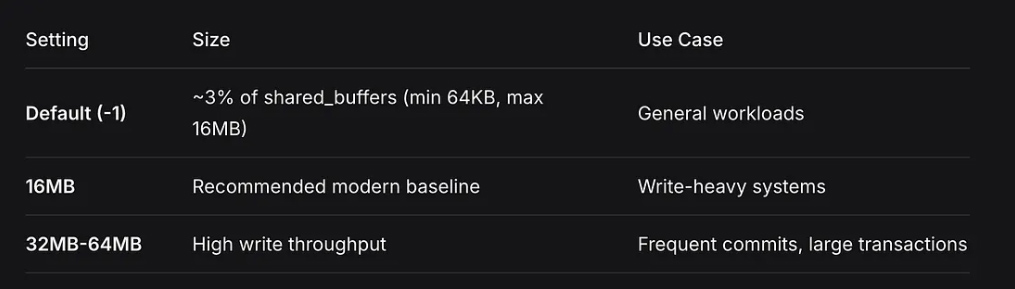
WAL Buffer چطور پر میشه؟
هر تغییر داده، از طریق تابع LogInsert یه WAL Record میسازه. Recordهای همهٔ Transactionهای همزمان توی همین فضای مشترک نوشته میشن.
کی Flush میشه؟
• Transaction Commit در حالت Synchronous: Backend که داره Commit میکنه، همهٔ WAL Recordها، حتی Recordهای Transactionهای دیگه، رو روی Disk مینویسه تا Durability تضمین بشه.
• پرشدن Buffer: وقتی Buffer پر بشه، Flush انجام میشه تا جا باز بشه.
• Background Writer: یه Process به اسم walwriter، دورهای Flush انجام میده؛ حتی برای Recordهای Transactionهایی که هنوز Commit نشدن.
نکتهٔ Performance اینجاست: اگه کلی Commit کوچیک داری، WAL Buffer بزرگتر اجازه میده چند Commit توی یه Flush جمع بشن و Throughput خیلی بهتر بشه!
۳-۳. CLOG Buffer کوچیک ولی حیاتی
CLOG Buffer یا Commit Log Buffer، همون Transaction Status Cache در PostgreSQL است؛ یه جزء کوچیک ولی حیاتی که خیلی از DBAها اصلاً بهش فکر نمیکنن.
CLOG چیه؟
CLOG وضعیت نهایی هر Transaction رو ثبت میکنه:
COMMITTED
ABORTED
IN_PROGRESS
برای ذخیرهٔ این اطلاعات، فقط دو Bit بهازای هر Transaction ID مصرف میشه؛ خیلی جمعوجوره!
چرا برای MVCC حیاتیه؟
PostgreSQL از MVCC یا Multi-Version Concurrency Control استفاده میکنه. وقتی از یه Row، Query میگیریم، باید دو چیز بررسی بشه:
کدوم Transaction این نسخه از Row رو ساخته؟ همون Creator Transaction ID.
آیا اون Commit ،Transaction شده؟
این بررسی مدام انجام میشه. اگه CLOG توی Memory نباشه، هر Query به Disk Read نیاز پیدا میکنه؛ یعنی یه دردسر جدی برای Performance.
محاسبهٔ اندازه بدون تنظیم مستقیم
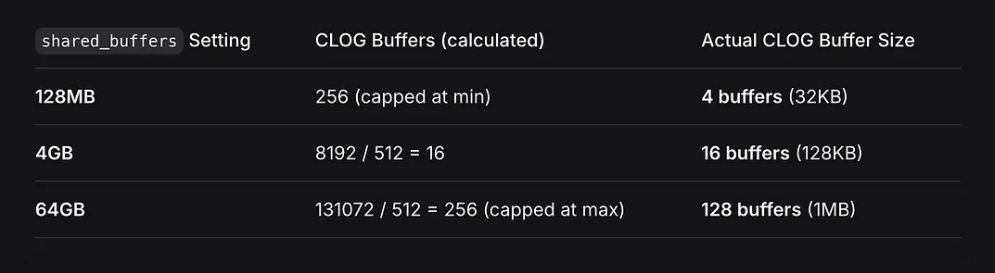
فرمولش سادهست: shared_buffers / 512، با حداقل ۴ و حداکثر ۱۲۸ تا Buffer. هر Buffer هم 8KB است.
⚠️ پس حواست به Bottleneck باشه: توی سیستمهایی با Transaction Rate خیلی بالا، تعداد کم Bufferهای پیشفرض ممکنه به Contention Bottleneck تبدیل بشه. اگه Workload این شرایط رو داره، شاید همین فضای کوچیک یه محدودیت پنهان Performance باشه:
بیش از ۱۰٬۰۰۰ Transaction در ثانیه.
تعداد زیادی Session همزمان.
CLOG چطور Flush میشه؟
Checkpoint: همهٔ Dirty CLOG Bufferها توی مسیر pg_xact/ روی Disk نوشته میشن.
Buffer Eviction: وقتی Dirty Pageها از Buffer بیرون میرن، روی Disk نوشته میشن.
Clean Shutdown: وقتی Database درست خاموش میشه، Flush کامل انجام میشه.
👈🏼 نکتهٔ کلیدی اینه: وقتی WAL Commit Record، Flush بشه، Commit اون Durable ،Transaction حساب میشه. لازم نیست خود CLOG همون لحظه Durable بشه؛ اگه Crash رخ بده، WAL Replay وضعیت درست Commit رو دوباره میسازه.
۳-۴. Lock Manager و کنترل Concurrency
وقتی چند Backend میخوان به Objectهای یکسان دسترسی داشته باشن، Lock Manager در PostgreSQL دسترسیها رو هماهنگ میکنه. این بخش توی Shared Memory پیادهسازی شده و دو ساختار اصلی داره:
ساختارهای دادهٔ اصلی
• ساختار LOCK: برای هر Object قابلقفل، مثل Table، Page یا Tuple که الان Lock داره یا براش Lock درخواست شده، یه نمونه وجود داره.
• ساختار PROCLOCK: برای هر ترکیب Backend و Object از نوع LOCK، یه نمونه وجود داره؛ یعنی مشخص میکنه یه Backend خاص، یه Lock خاص رو نگه داشته.
Fast Path برای بهبود Performance
از PostgreSQL 9.2، یه سازوکار Fast Path برای رایجترین Lockهای ضعیف اضافه شد:
AccessShareLock
RowShareLock
RowExclusiveLock
این Lockها توی عملیات معمول SELECT، INSERT، UPDATE و DELETE گرفته میشن. بهجای استفاده از Lock Manager سنگین، توی یه آرایهٔ کوچیک مخصوص هر Backend در ساختار PGPROC ثبت میشن؛ اینطوری Contention روی LWLockهای Lock Manager اصلی کمتر میشه.
نتیجهاش، بهبود قابلتوجه Performance توی سیستمهای Multi-core است.
تعیین اندازه
اندازهٔ Lock Tableها از قبل و با این پارامترها حساب میشه:
SHOW max_connections;
SHOW max_locks_per_transaction;  -- Default: 64
Monitoring برای Lockها
برای دیدن Queryهای Blockشده، این Query رو اجرا کن:
SELECT pid, locktype, relation::regclass AS table_name, mode, granted
FROM pg_locks
WHERE NOT granted;
اگه از ظرفیت max_locks_per_transaction رد بشیم چی میشه؟
max_locks_per_transaction محدودیت جداگانه برای تکتک Transactionها نیست. این پارامتر موقع Startup سرور، اندازهٔ کل Shared Lock Table توی Memory رو تعیین میکنه. اسمش از نظر تاریخی گمراهکنندهست؛ در واقع با یه پارامتر برای Capacity Planning کل سیستم Database طرفیم.
محاسبهٔ ظرفیت
موقع PostgreSQL ،Startup تعداد کل Lock Slotهای موجود رو اینطوری حساب میکنه:
Total Lock Slots = max_locks_per_transaction × (max_connections + max_prepared_transactions)یه مثال با مقادیر پیشفرض:
max_locks_per_transaction = 64
max_connections = 100
ظرفیت کل: 64 × 100 = 6,400 Lock Slots
چه Objectهایی Lock میشن؟
Lock ،PostgreSQLهای Objectهای Database رو نگه میداره، نه Lockهای Rowها:
Tableها
Indexها
Partitionها
Schemaها
Databaseها
Tablespaceها
⚠️ نکتهٔ مهم: Row-level Lockها مثل SELECT ... FOR UPDATE از یه سازوکار ذخیرهسازی دیگه روی Disk استفاده میکنن و Shared Memory Lock Slot مصرف نمیکنن.
پیامد عبور از ظرفیت
اتفاق فوری اینه که Transaction با این خطا Abort میشه:
ERROR: out of shared memory
HINT: You might need to increase max_locks_per_transaction.
ممکنه Out of Memory رو اشتباه برداشت کنی: این خطا نمیگه RAM تموم شده؛ مشخصاً میگه Shared Lock Table پر شده. وسط همون Session هم راه میانبری برای ادامهٔ Transaction وجود نداره و Transaction نمیتونه جلو بره.
🔺جمعبندی و نکات کلیدی
توی این بخش، پایههای معماری Memory در PostgreSQL رو بررسی کردیم:
مدل Process-based برای Concurrency بالا به Connection Pooling نیاز داره.
برای Caching بهینه، Shared Buffers باید ۲۵ تا ۴۰٪ RAM باشه.
Huge Pages میتونه Performance رو بیش از ۵۰٪ بهتر کنه و باید THP رو غیرفعال کنی.
تنظیم WAL Buffer، Write Throughput رو بهتر میکنه.
CLOG Buffer کوچیک ولی حیاتیه و زیر Load خیلی شدید ممکنه Bottleneck بشه.
Lock Manager برای عملیات رایج، Fast Path دارد.
📋چکلیست آمادگی برای Production
• Connection Pooling رو با pgBouncer فعال کن.
• shared_buffers رو روی ۲۵٪ RAM تنظیم کن و حواست باشه Hit Ratio حداقل ۹۹٪ باشه.
• Huge Pages رو تنظیم کن و THP رو غیرفعال کن.
• برای Workloadهای Write-heavy، مقدار wal_buffers رو بین 16MB و 64MB بذار.
• وقتی Transaction Rate بالاست، CLOG Contention رو زیر نظر بگیر.
• برای Transactionهای پیچیده، max_locks_per_transaction رو دوباره بررسی کن.
❓در بخش بعد چی میخونیم؟
Local Memory، یعنی work_mem و maintenance_work_mem، و اینکه چرا بیشتر مشکلات Performance از همینجا شروع میشن.
اثر MVCC و اینکه چرا UPDATE روی Tableهای خیلی بزرگ اینقدر پرهزینهست.
Monitoring عملی با دستورهایی که کمک میکنن مشکلات Memory رو پیدا کنیم.
Sizing Cheat Sheet بهعنوان مرجع سریع تمام پارامترهای اصلی Memory.
اگه از این مقاله خوشت اومد، لایکش کن، برای مطالب بیشتر دربارهٔ PostgreSQL نویسنده رو دنبال کن و مقاله رو با دوستها و همکارهای DBA خودت به اشتراک بذار!
سؤال یا نظری داری؟ توی دیدگاهها بنویس؛ خوشحال میشم تجربهات رو دربارهٔ Memory Tuning در PostgreSQL بخونم.
سفر در زمان برای نجات دادهها!
وقتی کاربر میخواهد «شرط» بنویسد، نه «برنامه»!
داستان هوشیار: پایهریزی AI با Open WebUI در همکاران سیستم